Un agente para todo#
Cuando solo tienes un martillo, todos los problemas son clavos.
El agente se ha convertido en ese martillo. Cada vez veo más equipos que, ante cualquier problema, montan uno: un bucle multipaso que planifica, llama a herramientas, reflexiona sobre el resultado y vuelve a planificar. El problema es que esa inercia llega también a tareas que una regla local resuelve sin tokens de inferencia y, según su implementación, con mucha menos latencia que una llamada al modelo. Normalizar el formato de un ticket, mirar si un identificador existe en una tabla, contar cuántas veces se ha repetido una alerta en la última hora: nada de eso necesita razonar.
En Antes de construir tu primer agente de IA, en el blog de Keepler, hablaba de los datos que necesita un agente; aquí, de dónde no hace falta.
El síntoma aparece pronto: sistemas caros, que no se pueden reproducir ni auditar, y que alucinan en decisiones binarias donde un if da siempre la misma respuesta.
La pregunta que casi nadie hace antes de escribir el primer prompt es la única que importa: ¿qué parte de esto necesita de verdad razonar?
La tesis: razonar donde hace falta, y en ningún otro sitio#
No todo problema necesita un agente. Decidir dónde razonar es una decisión de arquitectura, y la IA tiene su sitio en ella. Hay trabajo que un modelo generativo hace bien y que una regla no puede hacer: interpretar texto libre, correlacionar una incidencia nueva con análisis de causa raíz (RCA) históricos escritos por personas distintas, extraer la causa raíz de una descripción ambigua. Es evidencia no estructurada, y ahí el razonamiento aporta valor de verdad.
Y hay trabajo que el determinismo hace mejor: clasificar contra un catálogo cerrado, decidir si se cruza un umbral, actuar sobre un dato exacto. Las reglas, las máquinas de estado y los lookups son repetibles, baratos y auditables por construcción. Así que lo que decide dónde razonar y dónde no es la naturaleza del dato que tocamos en cada paso.
No soy el único que lo ve así: los decision models apuntan en la misma dirección. Modelos como Strands Decider (Strands Labs) o Jev (TypeSafe) existen precisamente para no generar texto: reciben evidencia y un conjunto de opciones, y devuelven una decisión tipada con un score de confianza. Es IA diseñada para funcionar dentro de un flujo de control determinista. El principio se resume así: el decision model decide, el LLM redacta y el flujo de control sigue en tu código.
Por qué “un agente para todo” sale caro#
Meter un agente donde bastaba una regla no es un detalle estético. Lo pagas de cuatro formas:
- Coste económico. Cada decisión trivial paga tokens, multiplicados por el volumen. Con miles de tickets al día, razonar cada clasificación que una tabla de reglas resolvía gratis es un impuesto permanente. Lo caro es razonar donde no hacía falta.
- Incertidumbre. El mismo ticket puede recibir dos respuestas distintas. En un resumen es tolerable; para decidir si se despierta a alguien de guardia, no.
- Reproducibilidad y auditabilidad. “¿Por qué escaló este ticket?” hay que poder contestarlo meses después. Una rama determinista permite registrar qué regla se aplicó y con qué datos; “el modelo lo decidió aquella vez” no pasa una auditoría en un entorno regulado.
- Superficie de fallo. Cada llamada a un LLM suma riesgo de prompt injection, de alucinación y de dependencia de un endpoint. Una regla local no está expuesta a prompt injection ni se cae porque un endpoint esté saturado. Eso no la exime de validar sus entradas.
El patrón: el flujo es determinista, el razonamiento es un servicio#
Las cuatro facturas tienen el mismo origen: inferencia donde no hacía falta. La solución no es quitar el modelo, sino acotarlo. El patrón separa el flujo en tres zonas. Veamos en el diagrama cómo las cruza un ticket de triaje L1, con AWS Step Functions orquestando el recorrido completo:
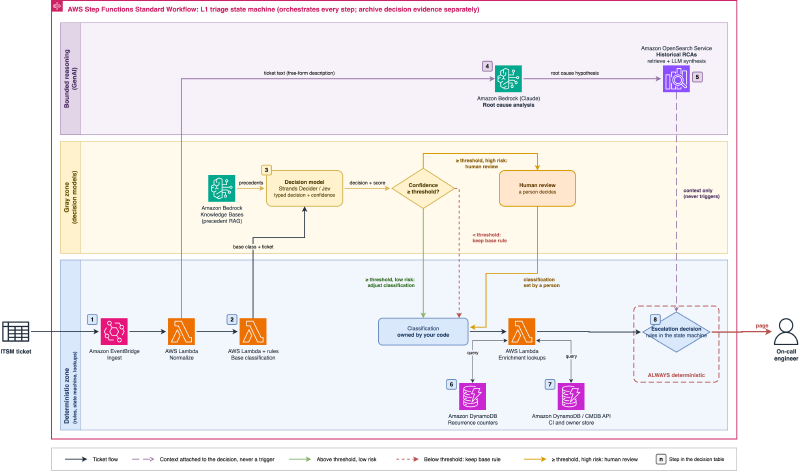
Zona determinista. Es el esqueleto del sistema: reglas, una máquina de estados y lookups. Aquí viven la clasificación base por palabras clave, la consulta a la CMDB (base de datos de configuración), la detección de recurrencia por conteo y umbral, y la decisión de escalado. Todo lo que es dato estructurado, catálogo cerrado o umbral numérico se queda en esta zona. Es barata, repetible y deja traza.
Zona de razonamiento acotado. Aquí entra el GenAI, pero con un trabajo bien delimitado: análisis de causa raíz sobre descripciones en texto libre y correlación semántica con RCAs históricos. “Acotado” es la palabra clave. El modelo recibe una pregunta concreta sobre evidencia no estructurada y devuelve una interpretación; el flujo lo conduce la máquina de estados.
Zona gris: los decision models. Es la bisagra entre las dos anteriores. La clasificación base es determinista, pero se ajusta si el RAG (retrieval-augmented generation) encuentra precedentes de incidencias parecidas. Ese ajuste lo decide un decision model que devuelve una opción tipada más un score de confianza, no un LLM en prosa. El flujo de control sigue siendo tuyo. Si la confianza no alcanza el umbral, se mantiene la clasificación por reglas. Si lo alcanza en una categoría de alto riesgo, decide una persona. El decider informa; tu código decide qué hacer con esa información.
En AWS Step Functions ese reparto es un estado Choice con una rama Default. Este fragmento es un extracto (los nombres de estados y de campos son míos, y el umbral viaja en la entrada para no codificarlo en la máquina de estados); lo he validado con aws stepfunctions validate-state-machine-definition dentro de una máquina de estados mínima:
"AdjustClassification": {
  "Type": "Choice",
  "Choices": [
    {
      "And": [
        { "Variable": "$.decision.confidence", "NumericGreaterThanEqualsPath": "$.config.confidenceThreshold" },
        { "Variable": "$.classification.highRisk", "BooleanEquals": true }
      ],
      "Next": "HumanReview"
    },
    {
      "Variable": "$.decision.confidence",
      "NumericGreaterThanEqualsPath": "$.config.confidenceThreshold",
      "Next": "ApplyAdjustedClassification"
    }
  ],
  "Default": "KeepBaseClassification"
}
Tiene tres salidas. Si la confianza alcanza el umbral y la categoría es de bajo riesgo, se aplica el ajuste. Si lo alcanza pero la categoría es de alto riesgo, el ticket va a revisión humana (la rama naranja del diagrama). Si no llega al umbral, la ejecución cae en Default y la clasificación por reglas se mantiene. El orden importa: Choice evalúa las reglas en orden y toma la primera que coincide, así que la ruta humana va antes.
El fallo del propio decider es otro caso. El diseño previsto es poner un Catch en el estado Task que lo invoca y redirigir a KeepBaseClassification. Ese Task y su Catch no están en el fragmento de arriba y no los he validado; el mecanismo está descrito en la documentación de gestión de errores de AWS Step Functions.
Visto como máquina de estados, cada transición del ajuste es una condición explícita: el modelo aporta el score y tu código elige la rama.
stateDiagram-v2
    [*] --> InvokeDecider
    InvokeDecider --> AdjustClassification: decision + score
    InvokeDecider --> KeepBaseClassification: Catch (decider failure)
    AdjustClassification --> HumanReview: confidence ≥ threshold and high risk
    AdjustClassification --> ApplyAdjustedClassification: confidence ≥ threshold and low risk
    AdjustClassification --> KeepBaseClassification: below threshold (Default)
    ApplyAdjustedClassification --> [*]
    KeepBaseClassification --> [*]
    HumanReview --> [*]
¿Y dónde corre el decider? Strands Decider es open source y puede correr en tu propio cómputo; su guía de despliegue documenta el self-hosting del servidor y un endpoint de Amazon SageMaker. La máquina de estados lo invoca desde el estado Task InvokeDecider. No incluyo una implementación de referencia, ni doy por hecho que Jev se despliegue igual.
El ejemplo: triaje L1 de incidencias, paso a paso#
El diagrama de las tres zonas ya enseña el recorrido completo de un ticket de triaje de nivel 1 en un sistema ITSM (gestión de servicios de TI). Ahora vamos a bajarlo a una tabla: llega un ticket y hay que clasificarlo, enriquecerlo con contexto y decidir si se resuelve, se agrupa o se escala. En cada paso, fíjate en qué parte razona y qué parte no.
| Paso | Tarea | Enfoque | Por qué | Servicio AWS |
|---|---|---|---|---|
| 1 | Ingesta/normalización del ticket | Determinista | Formato conocido | Amazon EventBridge / AWS Lambda |
| 2 | Clasificación base | Determinista (reglas/palabras clave) | Repetible, auditable | AWS Lambda + tabla de reglas |
| 3 | Ajuste de clasificación por precedente | Decision model (Jev / Strands Decider + RAG) | Evidencia no estructurada; decisión tipada + confianza | Amazon Bedrock Knowledge Bases (RAG) + decider autoalojado (invocado desde un estado Task) |
| 4 | Análisis de causa raíz | Razonamiento (GenAI) | Interpretar texto libre | Amazon Bedrock (Claude) |
| 5 | Consulta de RCAs históricos | Determinista (recuperación) + razonamiento (síntesis) | La recuperación es un lookup; la síntesis razona | Amazon OpenSearch Service / Amazon Bedrock Knowledge Bases |
| 6 | Detección de recurrencia | Determinista | Conteo/umbral sobre histórico | Amazon DynamoDB + regla |
| 7 | Lookup CMDB (elementos de configuración, responsables) | Determinista | Dato estructurado exacto | Amazon DynamoDB / API CMDB |
| 8 | Decisión de escalado | Determinista, siempre | No puede ser probabilístico | Estado de reglas de la propia máquina de AWS Step Functions |
Leyendo la tabla de arriba abajo el reparto queda nítido: de ocho pasos, dos razonan de verdad (el análisis de causa raíz y la síntesis de RCAs), uno es la zona gris del decision model, y el resto es dato estructurado puro.
Fíjate en la última fila. El modelo puede razonar todo lo que quiera, pero la decisión que despierta a una persona a las 3 de la madrugada la toma una regla. El razonamiento le da contexto al escalado; nunca es quien lo dispara.
AWS Step Functions orquesta el flujo, pero su traza no es un archivo de auditoría: el historial de un Standard Workflow solo se puede consultar por API durante 90 días, y los Express Workflows no lo registran. Para contestar “¿por qué pasó esto?” meses después, usa un Standard Workflow y activa el registro en Amazon CloudWatch Logs. Además, guarda en un almacén duradero (por ejemplo Amazon DynamoDB o Amazon S3) los datos de entrada de cada decisión, la regla y su versión, el umbral aplicado, el resultado y un identificador de correlación, con una retención que cumpla tu requisito.
Limitaciones, costes y modos de fallo#
Antes de comprometerte con este reparto conviene medir dónde el patrón se gana y dónde se pierde.
Lo que cuesta#
Determinismo no es lo mismo que corrección: una regla mal escrita se equivoca siempre igual. Estos son los costes reales para el equipo que lo adopta:
- La tabla de reglas es un sistema más que mantener. Las reglas por palabras clave se rompen con formulaciones nuevas, con otros idiomas o con servicios que aún no están en el catálogo, y alguien tiene que revisarlas y versionarlas.
- Calibrar el umbral exige datos etiquetados. Hacen falta tickets históricos clasificados por personas para medir cuántas decisiones acepta por error y cuántas rechaza por error (falsas aceptaciones y falsos rechazos). Cuántos tickets necesitas y quién los etiqueta depende de tu catálogo y de tu tolerancia al error; no es algo que se pueda fijar aquí.
- El decider autoalojado es un componente más. Hay que desplegarlo, versionarlo, monitorizarlo y dimensionar el cómputo donde corre.
- Tres zonas y dos almacenes de recuperación añaden complejidad operativa frente a un único agente, y también más puntos que probar de forma independiente.
Si tu volumen es bajo y las decisiones son de poca consecuencia, ese coste puede no compensar.
Lo que ahorra#
Coste de inferencia. Pongamos números. Un triaje L1 que recibe 10.000 tickets al día y dos diseños: el “agente para todo”, que razona en los ocho pasos dentro de un bucle agéntico, y el diseño por zonas, que llama al LLM en dos pasos (causa raíz y síntesis de RCAs) y al decision model en el tercero.
| Diseño | Llamadas LLM/día | Tokens/día (entrada + salida) | Coste estimado/día | Coste estimado/mes |
|---|---|---|---|---|
| Agente para todo (8 pasos × 3 llamadas) | 240.000 | 552 M (480 M + 72 M) | ~$1.848 | ~$55.440 |
| Diseño por zonas (2 pasos LLM) | 20.000 | 70 M (60 M + 10 M) | ~$242 | ~$7.260 |
A las 20.000 llamadas del diseño por zonas hay que sumar 10.000 al decider, que no factura por token: Strands Decider es open source y su coste es el de la máquina donde lo despliegues. Con estos supuestos el diseño por zonas hace doce veces menos llamadas al LLM y cuesta unas ocho veces menos en inferencia. Sin embargo, no lo tomes como una cifra cerrada. Los tickets complejos alargan el bucle del agente y su contexto crece en cada vuelta, lo que agranda la diferencia; el prompt caching del system prompt repetido o un modelo más pequeño en los pasos fáciles la reducen. Haz las cuentas con tu volumen y tus prompts, pero la forma no cambia: el diseño por zonas paga inferencia donde hay evidencia no estructurada, y en ningún otro sitio.
La alternativa más barata es una sola llamada por ticket que lo clasifique todo. Cuesta menos, pero la clasificación sigue siendo probabilística. El registro de invocaciones de Amazon Bedrock guarda entrada y salida, y eso es una traza, no una decisión que puedas reproducir. Para acercarte a lo segundo tendrías que guardar además la versión del modelo, el prompt y el esquema de salida, y aun así el modelo no tiene por qué devolver lo mismo. El argumento del patrón no es solo el precio.
Latencia. Un decision model como Strands Decider resuelve en torno a 200 ms: un único forward pass, local, sin ida y vuelta a un endpoint de inferencia pesado. Un bucle agéntico multiturno, en cambio, encadena llamadas al LLM, cada una esperando a la anterior. En el escenario de arriba el agente hace 24 llamadas secuenciales por ticket; el diseño por zonas, 2 más la del decider, sin contar las herramientas. No he medido la latencia por llamada, así que no doy una cifra absoluta. Que esa diferencia de llamadas se traduzca en colas depende del volumen y de la concurrencia que admitas.
Modos de fallo#
Los modos de fallo importan tanto como el camino feliz. Veamos tres, cada uno con su mitigación:
- El decision model propone un ajuste equivocado. El umbral de confianza reduce el riesgo, no lo elimina: si el score no lo alcanza, el ajuste no se aplica y se mantiene la regla base. Pero un modelo puede estar seguro y equivocado, así que un ajuste que alcanza el umbral sigue pudiendo ser erróneo. Por eso las categorías de mayor riesgo deben pasar por revisión humana aunque la confianza sea alta.
- El RAG devuelve un precedente irrelevante. Nada garantiza que el decider baje la confianza de esa opción. Compruébalo con casos de prueba de recuperación irrelevante y añade comprobaciones de calidad de la recuperación (por ejemplo, una distancia mínima de similitud) antes de que el precedente llegue al decider.
- El decider o Amazon Bedrock no están disponibles. Sin decider se pierde el ajuste por precedente; sin Amazon Bedrock, el contexto de causa raíz. El diseño previsto en los dos casos es degradar a clasificación determinista en vez de caerse, con un
Catchen cadaTaskque llama a una de esas dependencias: el triaje sigue y los escalados siguen saliendo, aunque con menos contexto para quien los recibe.
Cuándo sí tiene sentido más autonomía#
Nada de esto es dogma anti-agente. Hay escenarios donde subir la autonomía sí tiene sentido: tareas exploratorias, de baja consecuencia o donde el espacio de acciones es demasiado abierto para una regla. Un ejemplo del mismo dominio sería la investigación L2 de una incidencia sin precedentes, donde un agente puede explorar logs y métricas, mientras el escalado sigue siendo una regla. Lo importante es que subir la autonomía sea una decisión consciente y medida, y no el estado por defecto al que caes porque montar un agente era lo que tocaba.
Para terminar#
La frontera se pone según la naturaleza del dato. Dato estructurado, catálogo cerrado o umbral numérico: regla. Texto libre, correlación semántica o evidencia ambigua: razonamiento. La pregunta no es “¿puedo meter un agente aquí?”, sino “¿qué estoy tocando en este paso?”.
El escalado, y cualquier decisión con consecuencia, es determinista y auditable: la IA la informa, no la toma. Si no puedes registrar por qué pasó y reproducirlo, no debería haberlo decidido un modelo. Eso sí, determinista no significa correcto: el patrón trae sus propios costes, como las reglas que hay que mantener, los datos etiquetados para calibrar el umbral y un componente más que operar.
Si estás diseñando un sistema así, recorre los pasos uno a uno y pregúntate qué dato toca cada uno. Donde el dato sea texto libre, usa el modelo. Donde sea un catálogo, un umbral o un identificador, usa una regla.
Referencias#
- Act When Certain, Ask When Not: Building Safer AI Agents with Local Decision Models
- strands-labs/strands-decider — GitHub
- Decision Time: Jev vs. a Fine-Tuned Classifier — Anaconda
- Search and Multi-Teacher Distillation with Jev — arXiv:2610.09188
- Amazon Bedrock pricing
- AWS Step Functions: Standard vs. Express Workflows